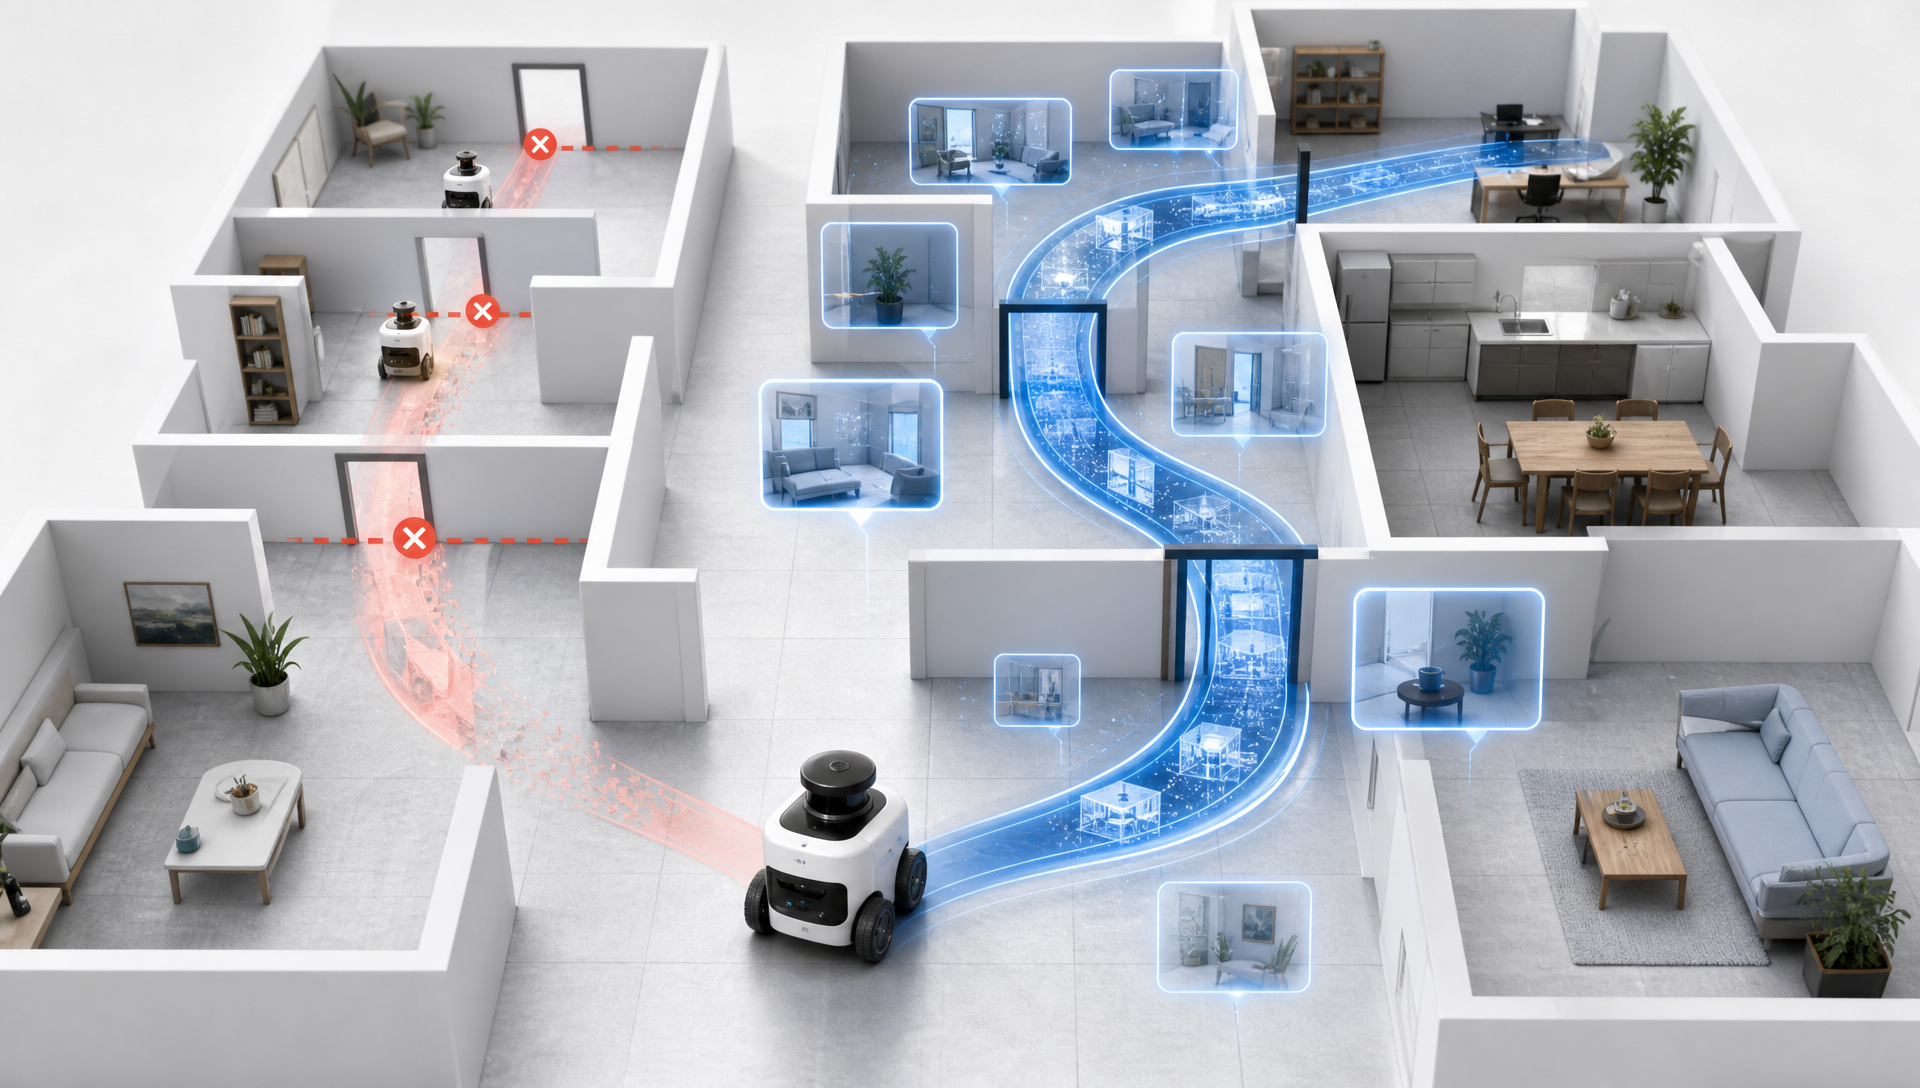
具身智能体的记忆不应只覆盖一次模型调用,也不应在一个训练 batch 结束时突然消失。真实导航是一个持续发生的过程:智能体需要记住走过的路线、见过的物体和此前的决策,并用这些信息理解当前处境。上下文越长,这种能力越重要。
StateLinFormer 从一个常被忽略的训练细节出发:线性注意力虽然能够以递归状态压缩历史,但常规训练会在每个 batch 开始时将状态清零。 模型在训练时从未真正学过如何长期维护记忆,自然很难在推理时仅凭更长的交互获得稳定的长时记忆。为此,我们提出有状态训练(Stateful Training),让记忆在连续训练片段之间持续传递。
长时导航中的两难:显式地图还是有限上下文
传统模块化导航系统通常维护显式地图。它们的记忆边界清楚、结构稳定,但地图表示和导航模块往往需要针对任务单独设计,对环境变化的适应能力有限。端到端 Transformer 更灵活,却受固定上下文窗口和二次复杂度约束;当轨迹不断延长,早期信息最终会被截断。
线性注意力提供了另一种可能。它将历史压缩进固定大小的递归状态,使计算和存储成本不再随上下文长度二次增长。然而,结构上可以保存状态,不等于模型已经学会使用状态。 如果每个训练片段都从零状态开始,模型仍会把 batch 边界当作记忆边界,长时记忆也就停留在架构层面的可能性,而没有成为训练所得的能力。
让记忆跨越 batch 边界
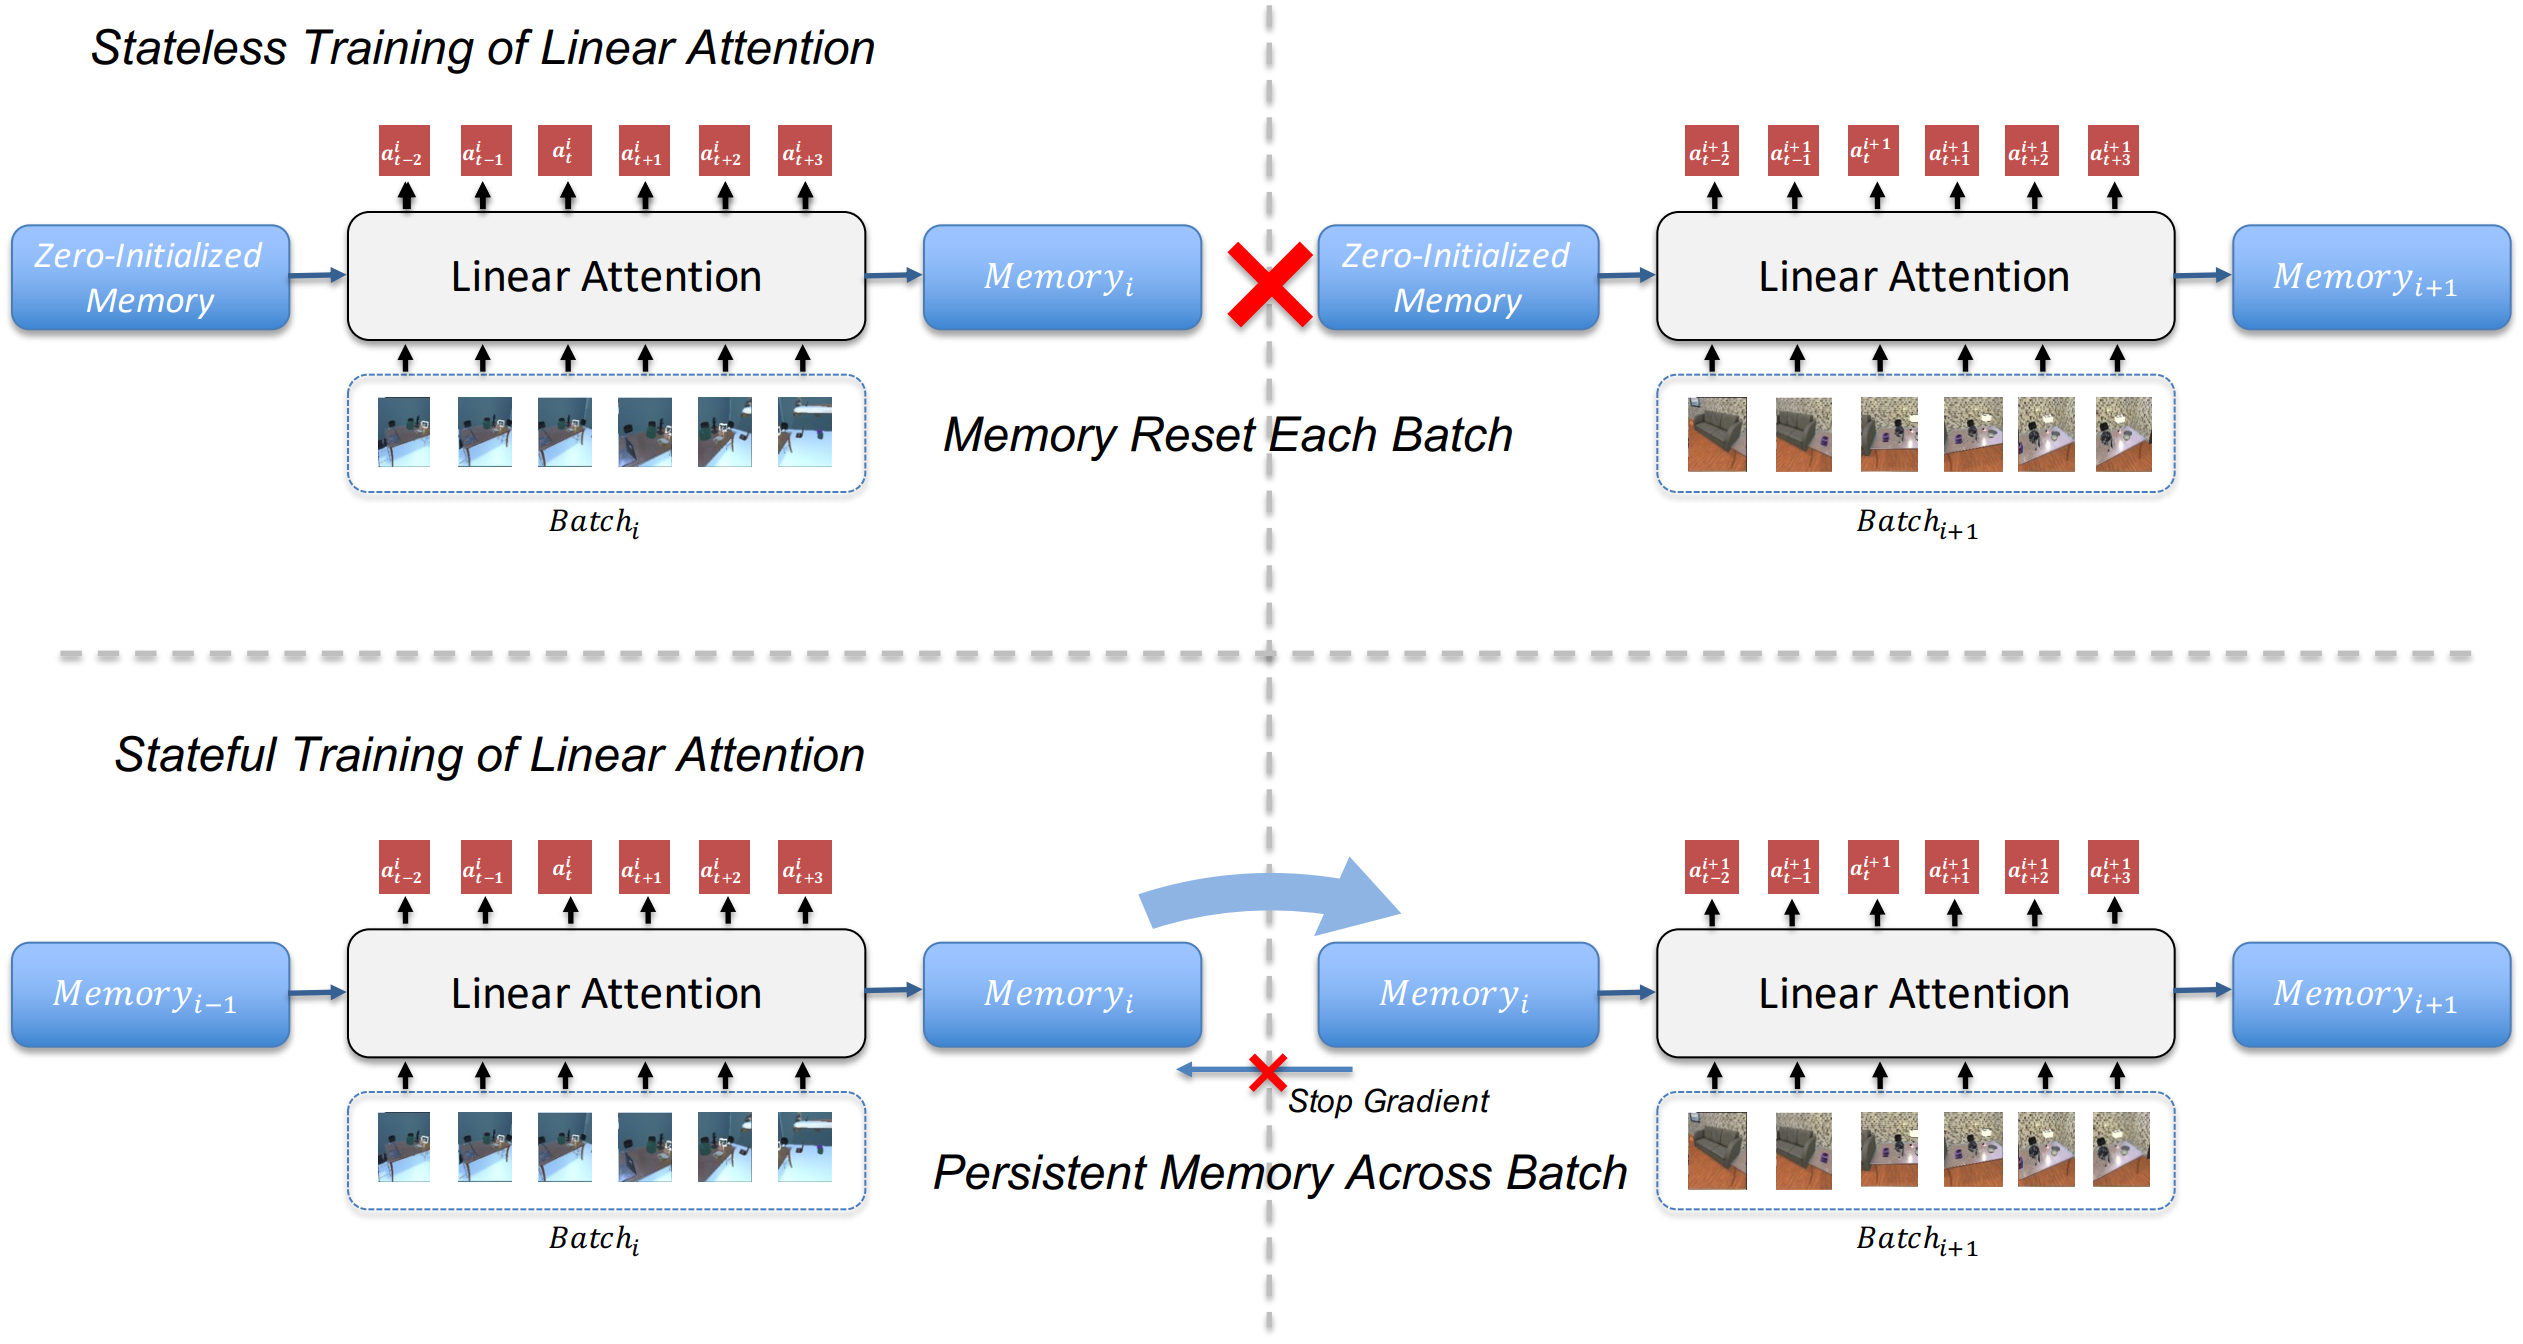 StateLinFormer 的核心差异。常规无状态训练在每个 batch 开始时清空记忆;有状态训练则把上一段结束时的记忆传给下一段,并在边界处停止梯度传播。
上图对比了两种训练方式。在无状态训练中,Batch_i 结束后产生的 Memory_i 会被丢弃,Batch_{i+1} 再从全零记忆开始。即使两个 batch 来自连续轨迹,它们对模型而言仍是彼此无关的样本。
StateLinFormer 按时间顺序组织训练片段,并将 Memory_i 作为下一段的初始状态。这样,有限长度的 batch 被连接成持续的经验流,训练过程可以近似对无限长序列的学习。与此同时,跨 batch 边界采用 stop-gradient:状态继续向前传递,但梯度不会沿整段历史无限回溯。这使模型能够保留长期信息,同时维持可控的显存占用和训练成本。
这个改动看似简单,实质上是在对齐训练与部署:推理时的智能体持续与环境交互,训练时的记忆也应处于同样的连续状态。
从记住历史到在上下文中适应
我们在网格化的 MAZE 和视觉更真实的 ProcTHOR 两类室内环境中进行验证。实验显示,在相同架构和参数规模下,StateLinFormer 持续优于无状态线性注意力模型;相较具有固定上下文窗口的 Transformer 基线,它也表现出更强的长时导航能力。
更值得注意的是,随着交互长度增加,有状态训练带来的收益会进一步扩大。持久记忆不仅帮助模型找回更早的空间信息,也让它能够根据此前的观察和反馈调整后续行为。这说明模型获得的不只是更大的“缓存”,还出现了更强的上下文学习(In-Context Learning)与在线适应能力。
记忆首先是一个训练问题
StateLinFormer 给出的核心结论是:长时记忆不仅取决于模型能容纳多少 token,也取决于训练过程是否要求模型维护一个持续、可用的内部状态。 扩大上下文窗口是在存储更多历史;有状态训练则是在教模型如何把历史沉淀为状态,并在未来真正使用它。
对于具身智能而言,这一点尤其重要。现实环境不会按照 batch 切分,智能体也不能在每段交互结束后重新开始。将持续状态引入训练,让高效的线性注意力从“理论上能够处理长序列”迈向“实际上能够形成长时记忆”,也为长期运行、自主适应的具身智能体提供了一条更直接的路径。