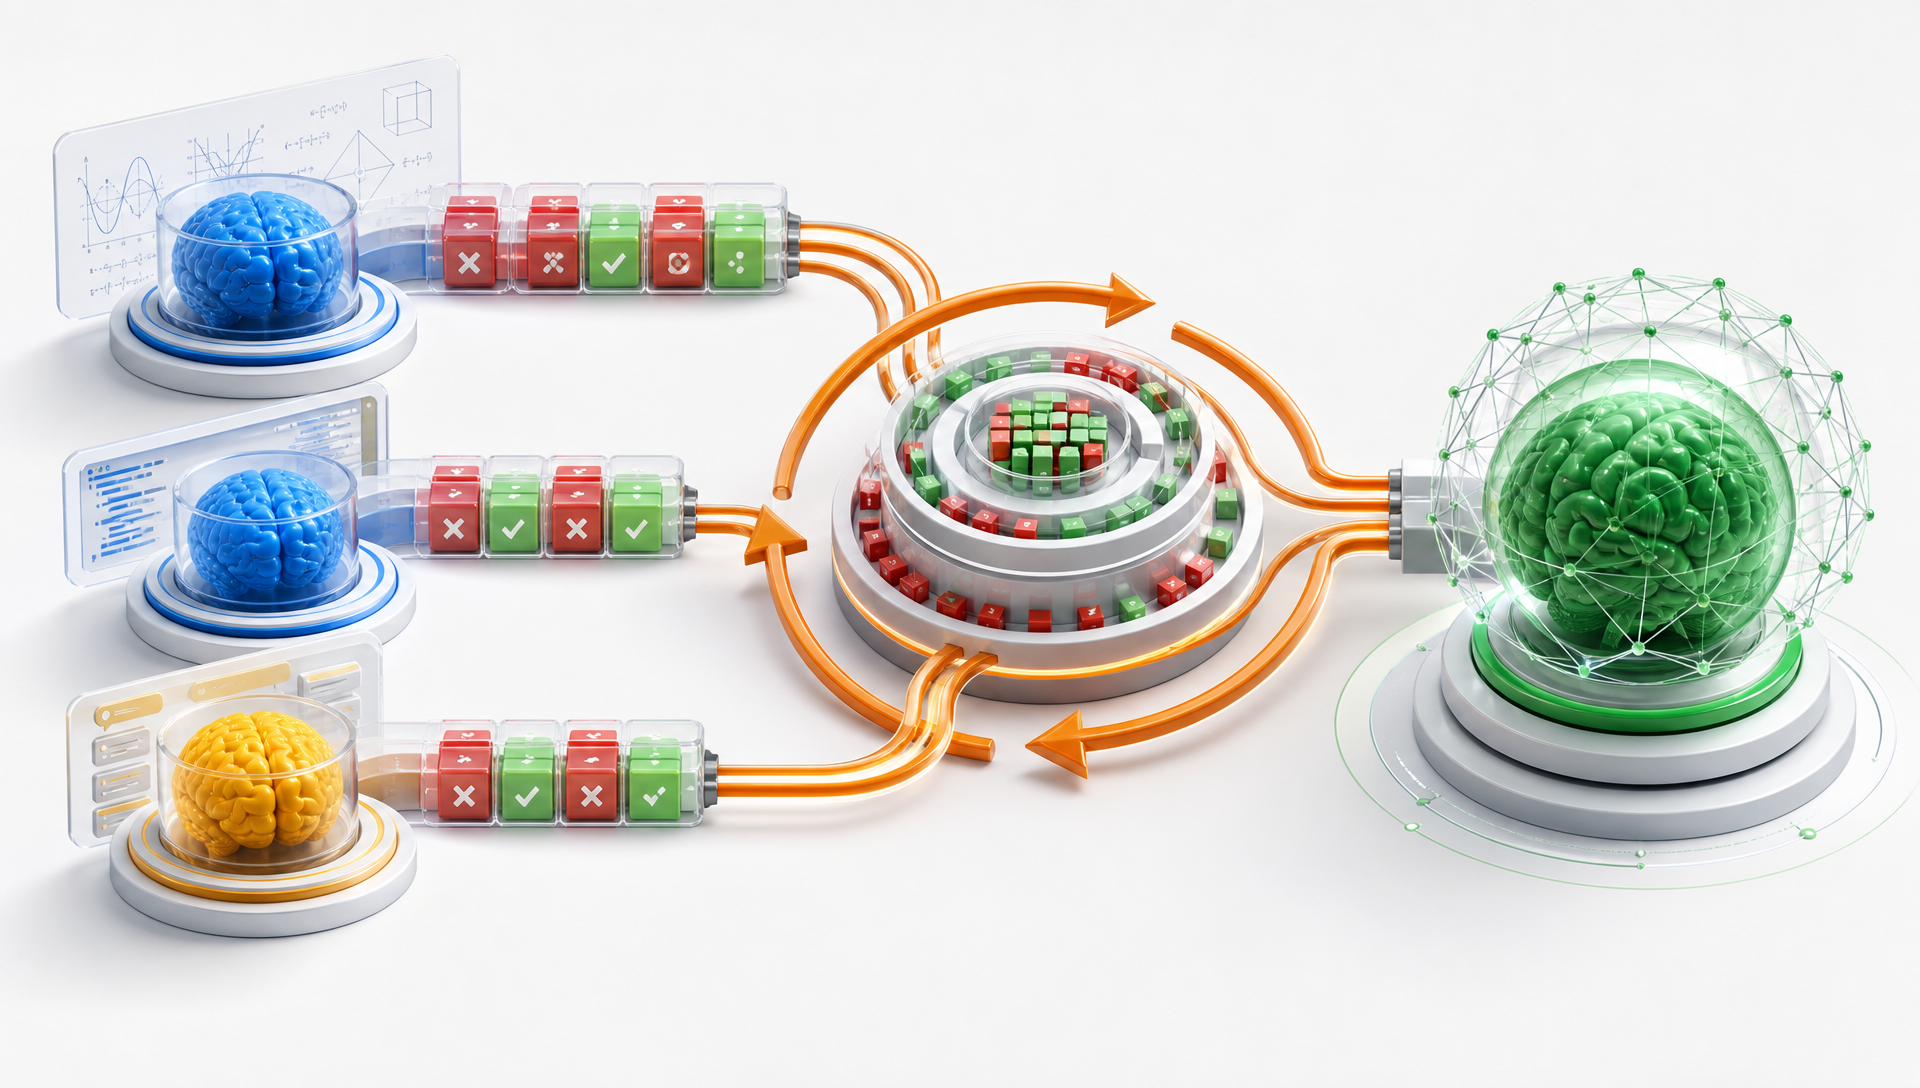
大规模在线强化学习正在成为提升大语言模型推理、代码生成和工具使用能力的重要手段。但当任务扩展到多个领域时,训练成本会迅速上升:每次策略更新都需要重新采样,生成过程与反向传播紧密耦合,昂贵的专家经验往往在一次训练结束后就被搁置。
REGEN(Replay-recycling for Expert-to-Generalist Distillation with Offline Reinforcement Learning)提出一个直接的问题:既然领域专家在强化学习过程中已经产生了大量回放数据,为什么还要让通才模型重新在线探索一次? REGEN 不再反复调用教师模型生成新轨迹,而是回收训练专家时自然产生的 replay memory,通过离线强化学习将多个领域的能力汇聚到一个通才模型中。
从多领域专家到统一通才
在数学推理、代码生成和指令遵循等领域,专门训练的模型通常能够取得更好的单项表现,但部署和维护多个专家并不理想。多教师在线策略蒸馏(Multi-teacher On-Policy Distillation, MOPD)提供了一种解决方式:学生模型在自身分布上生成轨迹,再由对应领域的教师提供监督信号。
MOPD 能够有效整合专家能力,却仍然依赖在线 rollout。模型生成、教师推理与参数更新必须协同运行,推理和反向传播无法彻底解耦。任务、教师和训练阶段越多,这种系统耦合带来的算力与工程成本就越明显。
REGEN 的出发点是把专家强化学习重新理解为一种数据合成过程。专家训练产生的轨迹并非一次性中间产物,而是一份已经包含探索结果、成功尝试和失败反馈的经验资产。只要能够处理好分布偏移和数据不均衡,这些经验就可以被新的通才策略反复学习。
回收 replay memory,而不是重新生成经验
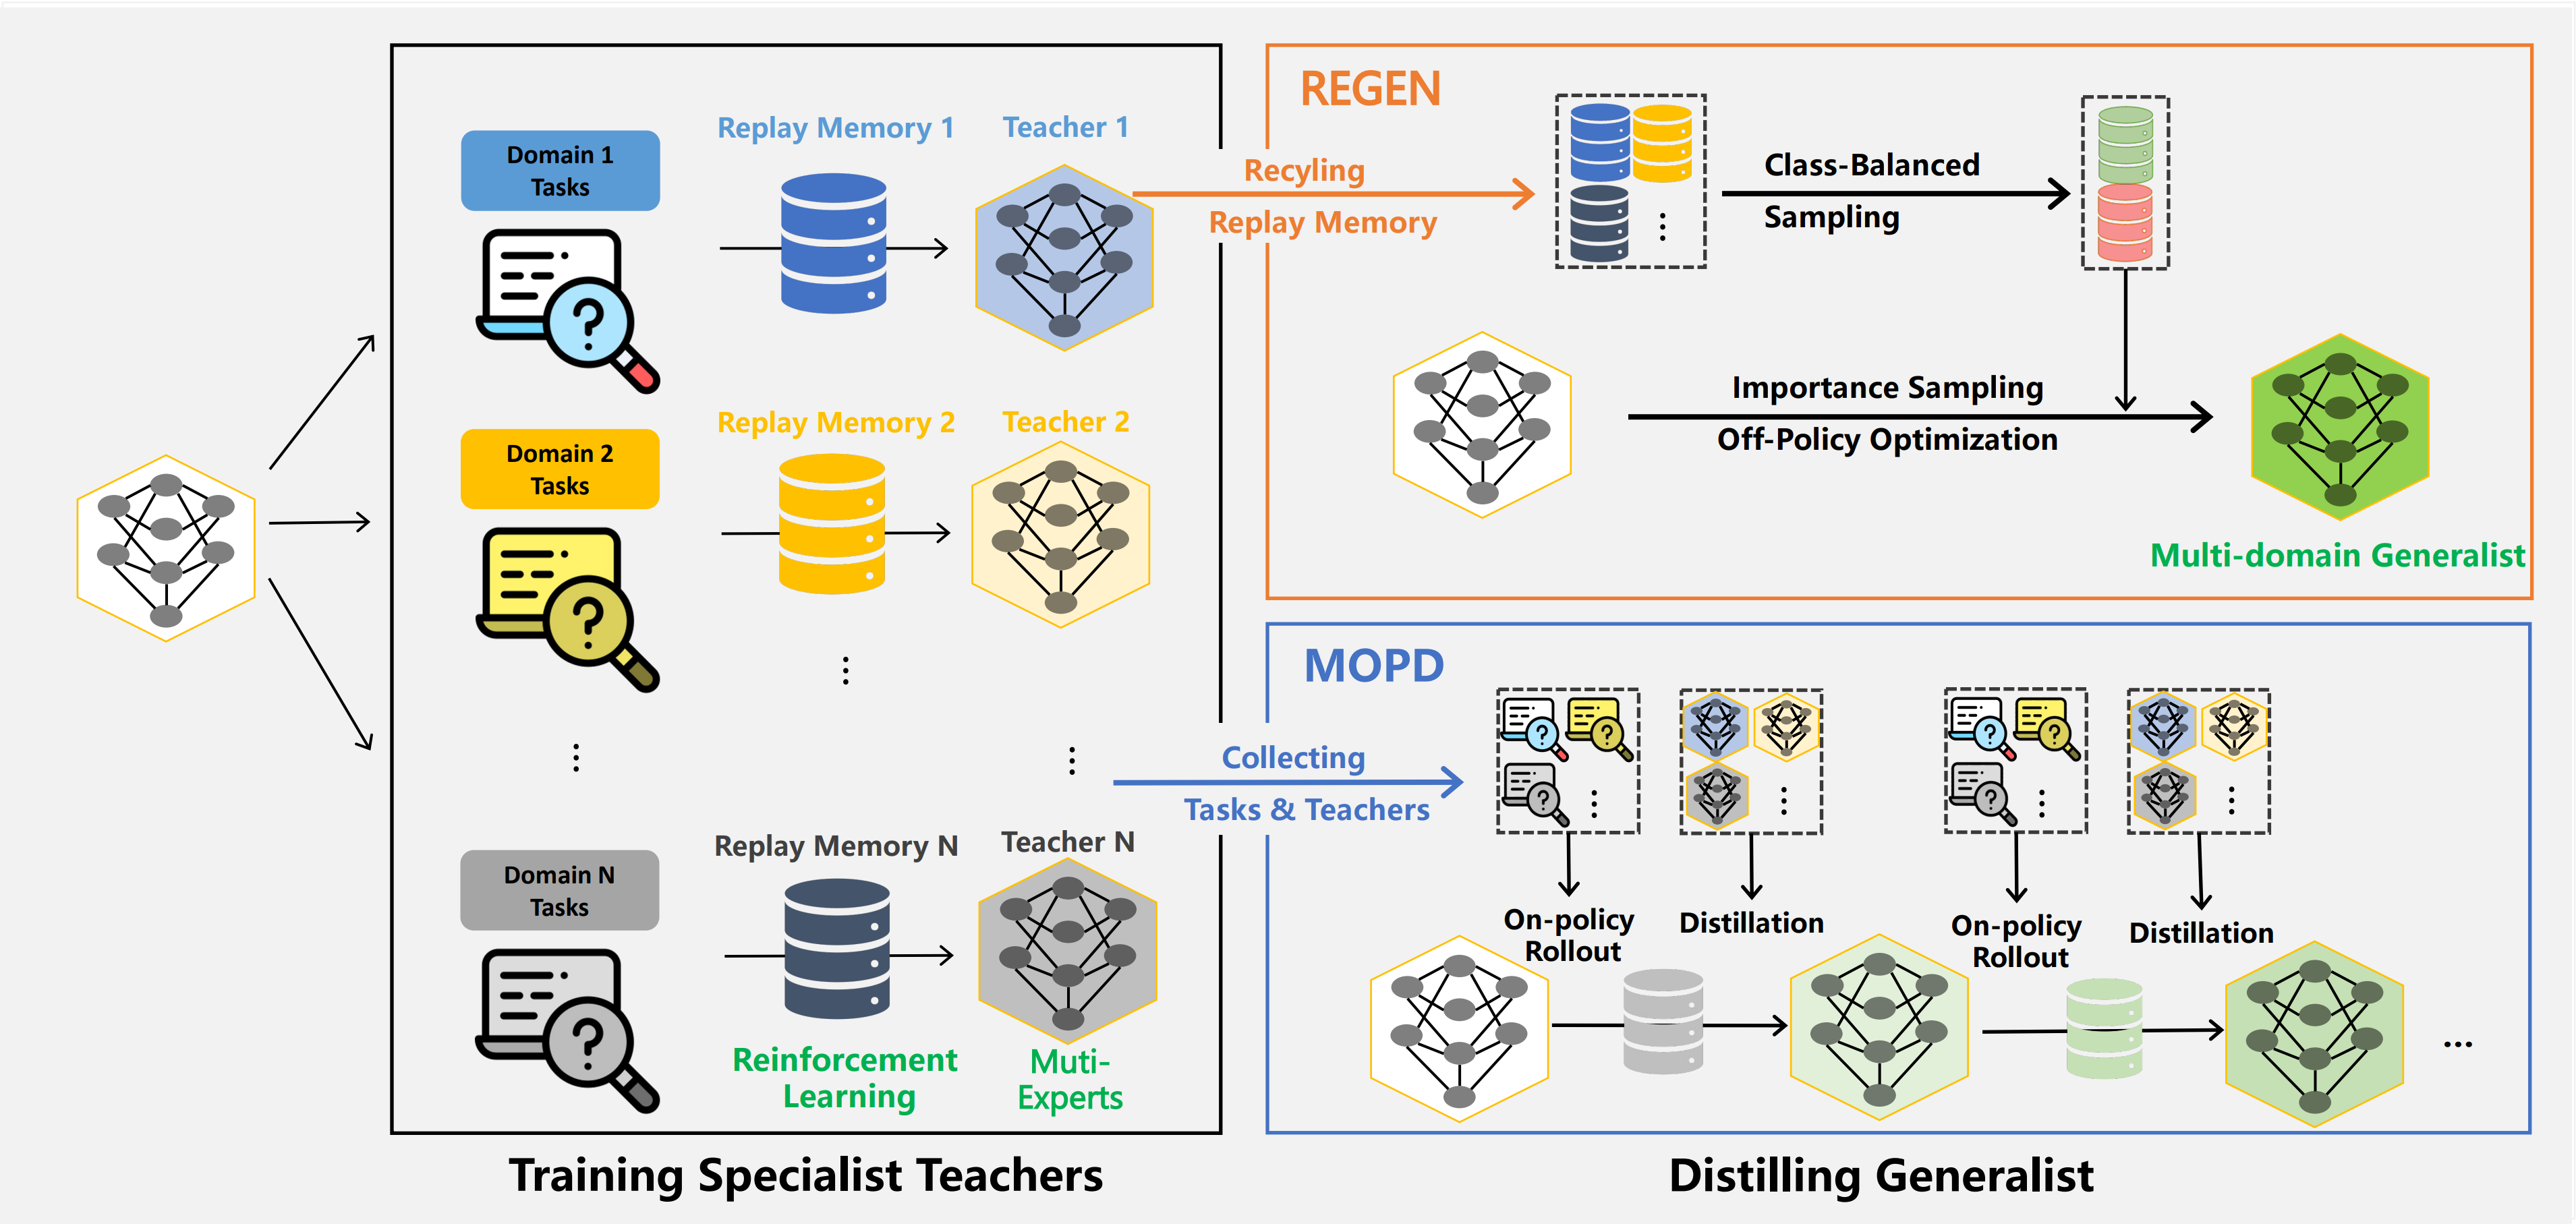 REGEN 与多教师在线策略蒸馏的对比。REGEN 汇总各领域专家训练产生的回放记忆,经类别均衡采样和带重要性采样的离线策略优化训练通才;MOPD 则需要反复进行在线 rollout 与教师蒸馏。
如图所示,REGEN 的训练过程由三个关键环节组成:
- 回放记忆回收。 每个领域专家在强化学习阶段都会留下 replay memory。REGEN 直接汇总这些已有轨迹,不再为通才训练重复执行昂贵的在线采样。
- 类别均衡采样。 回放数据中的正、负奖励样本往往高度不均衡。REGEN 保留同时包含正负响应的有效问题,并对两类样本进行均衡采样,避免某一类结果主导训练信号。
- 离线策略优化。 历史轨迹来自不同版本、不同领域的专家策略,与当前通才策略存在明显分布偏移。REGEN 使用带截断重要性采样的离线强化学习,在保留有效学习信号的同时控制离策略更新的方差。
由于 rollout 已经预先存在,训练端只需读取数据并执行反向更新。采样与学习由此完全解耦:同一份专家经验可以被多次使用,也可以在新模型、新配方或后续训练阶段中再次组合。
低成本并不意味着牺牲通用性
REGEN 在数学推理、代码生成和指令遵循任务上进行评估。结果表明,它能够以显著更低的训练成本达到与 MOPD 相当的准确率。其意义不仅是减少一次蒸馏的开销,更在于改变强化学习经验的生命周期:原本服务于单次专家训练的数据,可以继续参与通才训练和后续迭代。
这也使系统更容易扩展。当新增一个领域时,可以先独立训练专家并积累回放数据,再将新数据并入已有经验池,而不必同步启动所有教师进行联合在线蒸馏。不同团队、不同时间产生的专家经验,也有机会在统一的离线训练阶段中被重新组织。
从“一次性强化学习”到可积累的经验基础设施
当前大模型后训练通常把在线强化学习视为一次昂贵但短暂的阶段:训练结束,rollout 的价值也随之结束。REGEN 展示了另一种可能,即把 replay memory 当作可以持续积累、筛选和复用的基础设施。在线强化学习负责探索和生产高价值经验,离线强化学习负责低成本地传播与整合能力。
这并不意味着在线强化学习可以被完全替代。高质量专家和覆盖充分的经验仍然是 REGEN 的前提,静态数据也难以自动补足从未探索过的行为区域。但在已有多领域专家的场景下,REGEN 将“再训练一次”转化为“重新利用已经付费获得的经验”,为大规模、多阶段的模型后训练提供了更具可持续性的路径。